
LocalAI:开源 OpenAI 兼容本地推理引擎,CPU / NVIDIA / AMD / Apple Silicon 全硬件|部署与使用全指南
仓库:https://github.com/mudler/LocalAI 许可证:MIT 语言:Go 容器化:Docker / Podman 默认端口:8080 最新版本:README 标注 2026 年 10 月发布 4.11.0
1. 项目简介
LocalAI 是一个开源的本地 AI 推理引擎,定位为"在任意硬件上跑任意模型——LLM、视觉、语音、图像、视频,无需 GPU"。它采用"小核心 + 按需后端"架构:每个后端把一个主流引擎(llama.cpp、vLLM、whisper.cpp、stable-diffusion、MLX 等)打成独立镜像,只有用到对应模型时才拉取,不安装用不到的东西。对外提供 OpenAI、Anthropic、ElevenLabs 兼容 API,一次部署即可让现有 ChatGPT 客户端、Agent、RAG 应用平滑切换到本地。
1.1 核心信息一览
| 项目 | 说明 |
|---|---|
| 名称 | LocalAI |
| 仓库 | mudler/LocalAI |
| 定位 | 开源 OpenAI 兼容本地推理引擎,多模态、多硬件、可组合后端 |
| 许可证 | MIT |
| 语言 / 框架 | Go;后端为 llama.cpp / vLLM / whisper.cpp / diffusers / MLX 等 |
| 部署方式 | Docker / Podman、macOS DMG、源码编译、Kubernetes |
| 默认端口 | 8080 |
| 系统入口 | http://localhost:8080(API 与内置 WebUI) |
1.2 适用场景
- 想用一台机器私有跑 LLM,对外提供 OpenAI 兼容 API,替代 OpenAI 调用。
- 同时需要文本生成、语音转写、TTS、图像生成、嵌入、Rerank、视觉、对象检测等多种能力,不想分别维护多个服务。
- 硬件多样:NVIDIA CUDA、AMD ROCm、Intel oneAPI、Apple Silicon、Vulkan、纯 CPU。
- 多用户 / 团队场景:API Key 鉴权、用户配额、RBAC、用量统计。
1.3 能力边界(官方口径)
- 核心本身不带模型,后端镜像按需拉取;首次跑某类模型会自动下载对应后端与权重。
- 自托管需自行准备模型权重;商业模型版权与许可证由权重发布方决定。
- 分布式模式(PostgreSQL + NATS)用于横向扩展,不属于单机入门路径。
2. 功能特性
- 🧩 可组合后端:核心极小,后端以独立 OCI 镜像按需拉取,不装用不到的东西。
- 🔌 API 兼容:OpenAI、Anthropic、ElevenLabs 接口在每个后端上都可用。
- 🧠 多模态:文本生成、图像生成、语音转文字、文字转语音、嵌入、视觉、对象检测、Rerank、实时 API。
- 🖥️ 全硬件:NVIDIA CUDA 12/13、AMD ROCm、Intel oneAPI、Apple Silicon Metal、Vulkan、纯 CPU、Jetson L4T。
- 👥 多用户:API Key 鉴权、用户配额、RBAC、OIDC。
- 🤖 内置 Agent:带工具调用、RAG、MCP、Skills 的自主 Agent;社区 Agent Hub。
- 📦 模型来源广:官方 Model Gallery、HuggingFace、Ollama OCI registry、任意 YAML 配置、标准 OCI registry。
- 🧰 内置 WebUI 与终端
Agent:浏览器里直接聊天,也可在终端里
local-ai chat起一个会读你文件、跑命令的 Agent。 - 📊 可观测:用量统计、benchmark、分布式 fleet 面板。
3. 官方界面预览
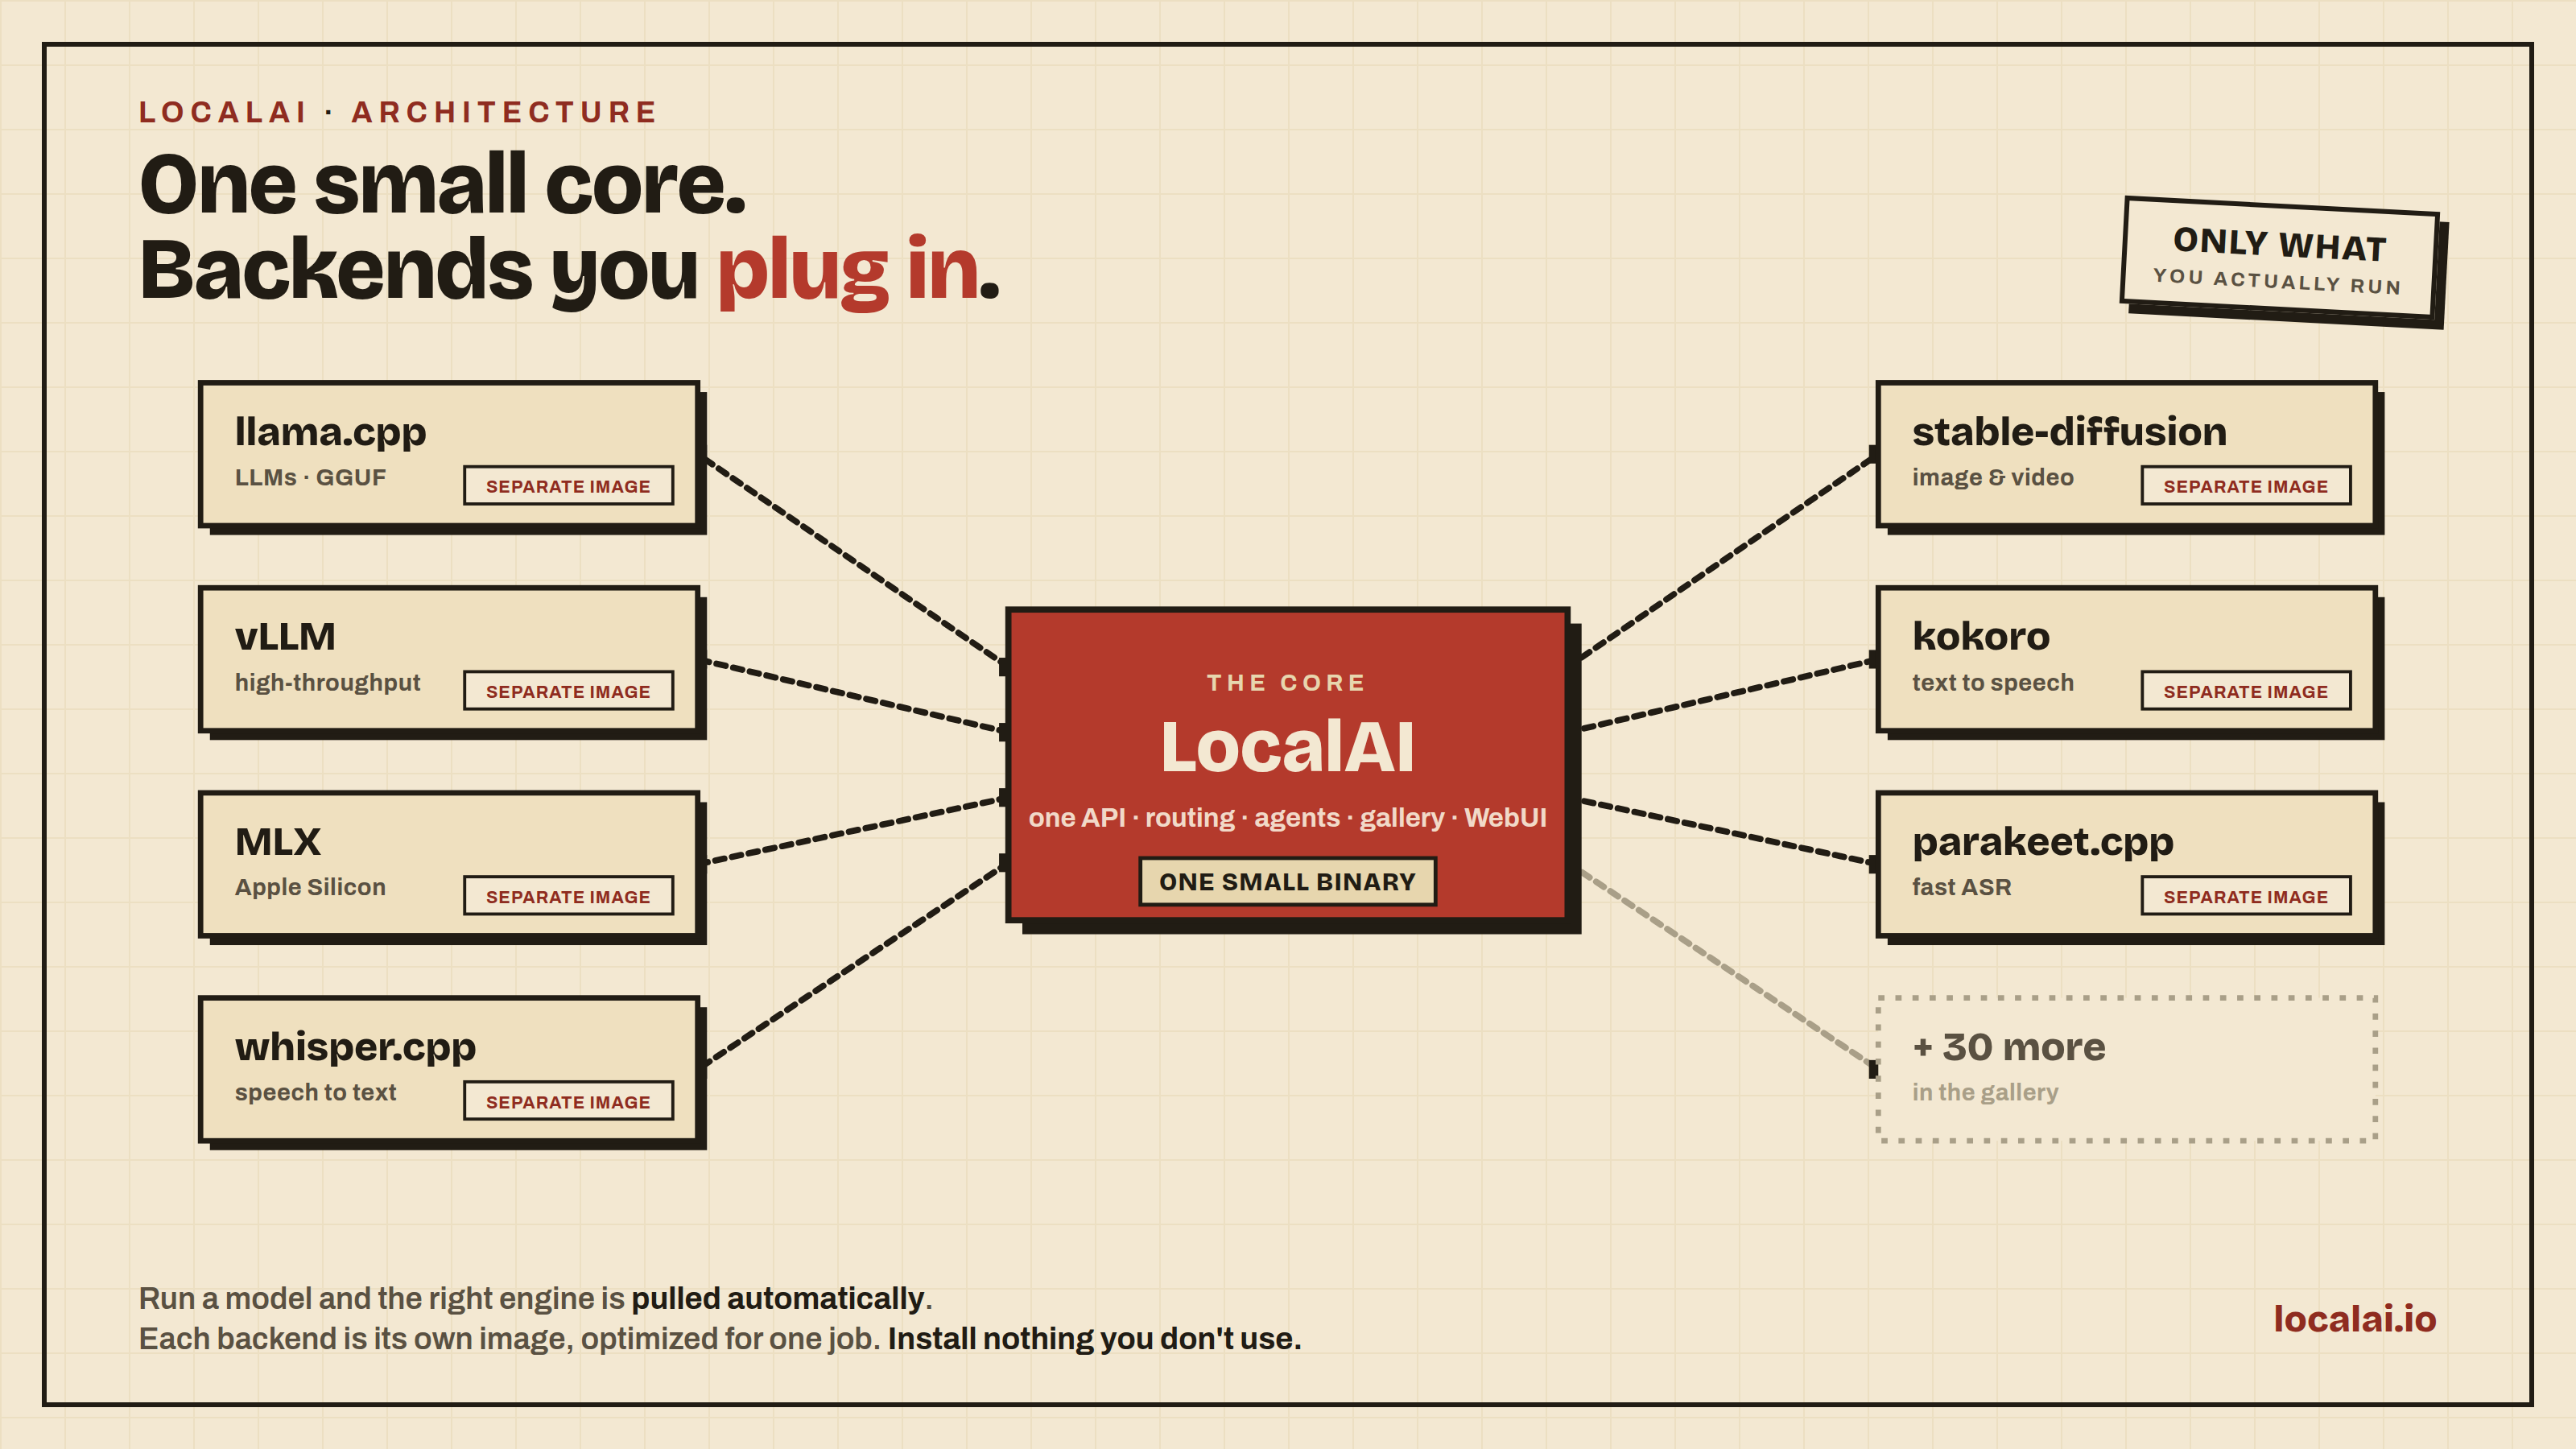
图为官方 README 的 composable-core 架构图:核心与各后端(llama.cpp、vLLM、MLX、whisper.cpp、stable-diffusion、kokoro、parakeet.cpp 等)解耦,按需拉取。
4. 官方跳转链接汇总
- 仓库:https://github.com/mudler/LocalAI
- 文档:https://localai.io/
- 模型 Gallery:https://models.localai.io/
- Backend Gallery:https://localai.io/backends/
- Discord:https://discord.gg/uJAeKSAGDy
- Docker Hub:https://hub.docker.com/r/localai/localai
- Releases(macOS DMG):https://github.com/mudler/LocalAI/releases
- Blog:https://localai.io/blog/
- 构建源码:https://localai.io/basics/build/
- Kubernetes:https://localai.io/basics/getting_started/#run-localai-in-kubernetes
5. 前置要求与服务器配置
5.1 软件前提
- Docker 或 Podman(容器方式推荐)。
- macOS 用户可直接下载 DMG 安装包。
- 想跑 GPU 加速时,对应硬件驱动 / Toolkit(NVIDIA 推荐用官方 CUDA 镜像)。
5.2 硬件与系统建议
- 纯 CPU:可跑 1B–7B 量级量化模型,速度按机器 CPU 与内存决定。
- NVIDIA GPU:按所选模型显存选镜像(CUDA 12 / 13)。
- AMD GPU:ROCm 镜像。
- Apple Silicon:走 MLX 后端,统一内存即可。
- Intel GPU:oneAPI 镜像。
- Vulkan:跨厂商 GPU 通用。
- Jetson:L4T 专用镜像(AGX Orin / DGX Spark)。
5.3 端口分配
| 端口 | 服务 | 说明 |
|---|---|---|
| 8080 | LocalAI API + WebUI | 容器默认映射 |
5.4 磁盘与模型
- 后端镜像按需拉取;模型权重从 Gallery / HuggingFace 下载,单个 7B Q4 模型约 4–5 GB。
- 长期使用建议挂载数据卷保留模型缓存,避免每次重建容器重新下载。
6. 方式一:Docker / Compose 一键部署(推荐)
6.1 纯 CPU 版
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest6.2 NVIDIA GPU
# CUDA 13
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13

# CUDA 12
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-12

# NVIDIA Jetson ARM64(CUDA 12,AGX Orin 等)
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-nvidia-l4t-arm64

# NVIDIA Jetson ARM64(CUDA 13,DGX Spark)
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-nvidia-l4t-arm64-cuda-13
6.3 AMD GPU(ROCm)
docker run -ti --name local-ai -p 8080:8080 \
  --device=/dev/kfd --device=/dev/dri --group-add=video \
  localai/localai:latest-gpu-hipblas
6.4 Intel GPU(oneAPI)
docker run -ti --name local-ai -p 8080:8080 \
  --device=/dev/dri/card1 --device=/dev/dri/renderD128 \
  localai/localai:latest-gpu-intel
6.5 Vulkan GPU
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest-gpu-vulkan6.6 加载模型
# 从官方 Model Gallery
local-ai run llama-3.2-1b-instruct:q4_k_m

# 从 HuggingFace
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf

# 从 Ollama OCI registry
local-ai run ollama://gemma:2b

# 从 YAML 配置
local-ai run https://gist.githubusercontent.com/.../phi-2.yaml

# 从标准 OCI registry(Docker Hub)
local-ai run oci://localai/phi-2:latest
已经跑过 LocalAI 想重启已有容器:
docker start -i local-ai。
7. 方式二:源码 / 本地运行
7.1 macOS DMG
直接从 Releases 下载 DMG 安装。
DMG 未做 Apple 签名,安装后需要执行:
sudo xattr -d com.apple.quarantine /Applications/LocalAI.app
7.2 终端 Agent 用法
# 终端 1:起服务并加载模型
local-ai run llama-3.2-1b-instruct:q4_k_m

# 终端 2:起内置 Agent 聊天
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
会话内:
/models列出已安装模型/model <name>切换模型
7.3 从源码构建
参考官方文档 Build from source。
7.4 Kubernetes
参考 Kubernetes 安装。
8. 配置项说明
LocalAI 配置走环境变量与模型 YAML,常见关键项:
| 配置项 | 用途 | 默认 / 示例 |
|---|---|---|
| 端口 | 监听端口 | 8080 |
| API Key 鉴权 | 多用户 / 对外开放时启用 | LOCALAI_API_KEY 或走 OIDC |
| 模型 Gallery | 模型来源 | models.localai.io |
| 后端自动检测 | 自动下载匹配 GPU 的后端 | 默认开启 |
| 模型 YAML | 单个模型的参数、模板、后端 | 见 Gallery 中每个模型的 yaml |
| 数据卷 | 保留模型缓存与配置 | 建议挂载 /models 等目录 |
完整环境变量与模型 YAML 字段以 localai.io 最新文档为准;README 明确"不安装用不到的后端",首次跑某类模型会自动拉取对应镜像。
9. 常用运维命令
# 启动 / 停止 / 重启
docker start local-ai
docker stop local-ai
docker restart local-ai

# 查看日志
docker logs -f local-ai

# 进入容器
docker exec -it local-ai sh

# 拉取最新镜像
docker pull localai/localai:latest
docker stop local-ai && docker rm local-ai
# 然后按 6.x 重新 run

# 列出已安装模型
local-ai models list

# 跑基准测试
local-ai benchmark

# 查看 GPU 识别情况(容器内)
nvidia-smi   # NVIDIA
rocm-smi # AMD备份:模型目录(/models
或你挂载的宿主机目录)与配置文件。
10. 常见故障排查
- 8080 被占用:改
-p 18080:8080或停掉占用进程。 - GPU 不识别:NVIDIA 镜像必须加
--gpus all;AMD 必须加--device=/dev/kfd --device=/dev/dri --group-add=video;Intel 必须加/dev/dri/card1与/dev/dri/renderD128。 - 首次跑模型很慢:在自动下载后端镜像与模型权重,看
docker logs -f local-ai进度。 - macOS DMG 打不开:未签名,按上面命令去隔离属性后再开。
- 模型下载失败 / 403:HuggingFace 限速或网络问题,换 Gallery / OCI 源,或配置代理。
- 显存不够:换量化版本(Q4_K_M / Q3_K_M)或更小参数模型;QLoRA 类场景另看文档。
- OpenAI 客户端连不上:把 base URL 指向
http://<host>:8080/v1,key 填你配置的 LocalAI key。 - 版本升级后行为变化:4.x 系列迭代很快(README 每月都有 release),升级前看 Release notes。
11. 风险与合规说明
- 许可证:LocalAI 代码采用 MIT 许可证;但它包装的后端(llama.cpp、vLLM、stable-diffusion 等)与模型权重各自有许可证,商用前请逐一核对。
- 模型版权:本地跑的权重(如 Llama、Qwen、DeepSeek 等)由对应模型发布方授权,禁止用于违反其许可的场景。
- 数据隐私:本地推理默认数据不出机器;但通过 API Key 对外开放时,请做好鉴权与配额,避免被滥用做违法内容生成。
- 开放暴露:默认无鉴权,公网部署务必加 API Key / OIDC / 反向代理鉴权。
- 第三方后端:本地调用的第三方模型 / 数据集由对应仓库维护,供应链与合规风险请自行评估。
- 硬件差异:不同后端镜像对 CUDA / ROCm 版本有要求,版本不匹配会启动失败,以 GPU Acceleration 文档为准。