
WhisperX:带词级时间戳与说话人分离的极速 Whisper 转写部署指南
WhisperX 是牛津大学 VGG 实验室开源的自动语音识别(ASR)项目,基于 OpenAI 的 Whisper 模型,主打「快速、精准、可分人」三大能力:使用 large-v2 模型时可达到 70 倍实时速的批量转写,并通过 wav2vec2 强制对齐获得词级时间戳,再借助 pyannote 完成说话人分离(diarization),给每段语音打上说话人编号。论文《WhisperX: Time-Accurate Speech Transcription of Long-Form Audio》已被 INTERSPEECH 2023 接收,项目还在 Ego4d 转写挑战赛中获得第一名;2026 年新发布的上下文感知批处理(Context-Aware Batching)进一步提升了标点与专有名词的准确率,对应预印本为 arXiv:2608.31170。
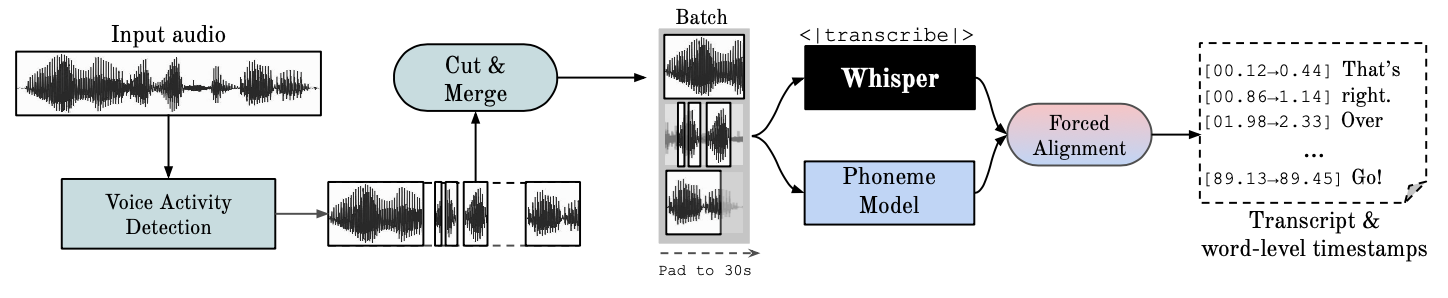
典型使用场景包括:长会议录音转写并区分不同发言人、视频字幕生成需要逐词对齐时间轴、播客与访谈的多人语音自动整理。传统 Whisper 虽然转写准,但句子级时间戳误差动辄数秒,且一次只能处理一小段音频,处理一小时录音要花很长时间;WhisperX 通过 VAD 切分、批量推理把速度提了几十倍,再用强制对齐把时间戳细化到词级,最后用说话人分离告诉你「这句话是谁说的」,四步流水线组合出完整的长音频转写方案。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| GitHub 仓库 | m-bain/whisperX |
| 论文 | INTERSPEECH 2023 论文 PDF、arXiv:2303.00747 |
| 开源协议 | MIT |
| 主要语言 | Python |
| 核心依赖 | faster-whisper、pyannote-audio、wav2vec2 对齐模型 |
| 在线 Demo | Replicate large-v3、Replicate large-v2 |
| 成果 | Ego4d 转写挑战赛第一名;INTERSPEECH 2023 收录 |
二、官方图片
WhisperX 项目官方配图:
三、项目原理与核心特性
WhisperX 并不是另起炉灶训练新模型,而是在 Whisper 外面包了一层「加速 + 对齐 + 分人」的工程流水线:它保留了 Whisper 的高转写准确率,同时把三个原版短板——时间戳不准、不能批处理、不分说话人——逐一补齐。
要理解 WhisperX,先明确四个基础概念:Whisper 是 OpenAI 开发的多语言 ASR 模型,在海量多样音频上训练,转录准确率高,但时间戳只到句子级、误差可达数秒,且原生不支持批量推理;音素 ASR 是一类微调过的模型,用于识别区分词与词的最小语音单位(例如 "tap" 中的 p),代表模型是 wav2vec2.0;强制对齐(Forced Alignment) 是把已转写文本对齐到音频、自动生成音素级分段的过程,相当于给每个单词在时间轴上「钉钉子」;语音活动检测(VAD) 判断音频中是否有人声,把静音和人声分开;说话人分离(Speaker Diarization) 则把音频按说话人身份切成若干同质片段,回答「谁在什么时候说话」。WhisperX 正是把这四件事串成流水线:先用 VAD 切段、Whisper 批量转写,再用 wav2vec2 对齐到词级,最后用 pyannote 分出说话人。
WhisperX 的核心特性包括:
- ⚡️ 批量极速推理:基于 faster-whisper 后端做 batched inference,把原本只能逐段处理的 Whisper 改成一次喂入多段音频并行推理,用 large-v2 达到 70 倍实时速转写——一小时录音大约一分钟内就能转完。
- 🪶 显存占用低:large-v2 在 beam_size=5 时只需不到 8GB 显存,普通游戏显卡或云 GPU 实例即可跑起来,无需专业大显存卡。
- 🎯 词级时间戳:用 wav2vec2 对齐把 Whisper 的句子级时间戳细化到每个词,解决原版 Whisper 时间戳偏秒级、字幕整体错位的问题,可直接用于逐词字幕。
- 👯♂️ 多说话人转写:通过 pyannote 的说话人分离给转录结果打上说话人 ID,自动区分「spk0」「spk1」,适合会议、访谈、播客等多人场景。
- 🗣️ VAD 预处理:基于语音活动检测先把静音段去掉再分块,既减少 Whisper 在静音上产生的幻觉(胡编内容),又让批处理更高效,论文证明该做法不降低词错率。
四、环境要求
GPU 加速需先安装 CUDA Toolkit 12.8(Linux 按 CUDA 安装指南,Windows 从 CUDA 下载页获取);仅用 CPU 可跳过这一步。此外还需 ffmpeg、rust 等基础工具(参考 OpenAI Whisper 安装说明)。Python 环境按官方推荐用 pip 或 uv 管理即可。显存方面,large-v2 加 beam_size=5 的常规配置约需不到 8GB;如果显存紧张,可以调小 --batch_size、改用 --compute_type int8,或换用 --model base 等更小的模型;长音频处理时建议按 Python API 里的做法,用完一步就释放对应模型,避免显存累积。
五、部署步骤
官方推荐绝大多数用户直接用 pip 安装稳定版,只有开发者或有特殊需求的用户才从 GitHub 或源码安装。装好后第一次运行会自动从 Hugging Face 下载 Whisper 模型、对应语言的对齐模型;开启说话人分离还需单独准备 HF token 并接受 pyannote 协议。
1. 简单安装(推荐)
pip install whisperx
也可用 uvx 直接运行,无需常驻安装:
uvx whisperx
2. 进阶安装方式
从 GitHub 直接安装:
uvx git+https://github.com/m-bain/whisperX.git
开发者安装(需改代码或贡献时):
git clone https://github.com/m-bain/whisperX.git
cd whisperX
uv sync --all-extras --dev
注意:开发版可能包含实验性特性与 bug,生产环境请使用 PyPI 稳定版。
3. 加速强制对齐(可选)
WhisperX 用动态规划做音素对齐,对长音频或 GPU 批处理管线,安装 Numba 可把对齐提速 30 到 100 倍:
pip install "whisperx[fast]"
# 或:pip install numba
装了 Numba 会自动启用 JIT 编译的对齐循环;没装则无缝回退到原生 PyTorch,无需额外配置。强制对齐虽然只占整个流水线的一小段,但在长音频上会随词数平方级增长,因此 Numba 加速对批量处理长录音的用户收益明显。
4. 开启说话人分离
说话人分离功能需要 Hugging Face 访问令牌:先在 HF Token 页面生成 read 权限的 token,接受 speaker-diarization-community-1 模型用户协议,然后在命令行通过 --hf_token 参数传入即可。这一步是免费的,只是流程上需要同意模型条款;没有 token 时 WhisperX 仍可转写与对齐,只是不会输出说话人编号。
六、使用方法
命令行
最简单的用法(默认 small 模型):
whisperx path/to/audio.wav
加 --highlight_words True 可在 .srt 字幕中高亮显示词级时间。对比如官方演示:原版 Whisper 转写的文字与音频常常错位,而 WhisperX 经 wav2vec2 强制对齐后,每个词都精确落在时间轴上。为提高时间戳精度(代价是显存增加),用更大模型并指定对齐模型:
whisperx path/to/audio.wav --model large-v2 --align_model WAV2VEC2_ASR_LARGE_LV60K_960H --batch_size 4
带说话人分离、并高亮词时间:
whisperx path/to/audio.wav --model large-v2 --diarize --highlight_words True
已知说话人数量时可用 --min_speakers 2、--max_speakers 2 约束;为保持上下文连贯(适合技术术语与标点),加 --interleaved_context:
whisperx path/to/audio.wav --model large-v2 --interleaved_context
在 CPU 或 Mac 上运行(用 int8 降低精度换显存):
whisperx path/to/audio.wav --compute_type int8 --device cpu
这组命令覆盖了从最简单到完整流水线的典型用法:不带任何参数即默认用 small 模型快速试跑;--model large-v2 换更大模型提升转写精度;--align_model 指定对齐模型(官方论文发现换更大对齐模型收益有限,主要靠 ASR 模型);--diarize 开启说话人分离;--highlight_words True 在 srt 字幕里把每个词的时间轴可视化;--interleaved_context 保持上下文连贯;--compute_type int8 --device cpu 则是无 N 卡时的兜底方案。
其他语言只需传 --language 代码,例如德语:
whisperx --model large-v2 --language de path/to/audio.wav
音素对齐模型是按语言区分的,英语、法语、德语、西班牙语、意大利语通过 torchaudio 管线自动选取,更多语言从 Hugging Face 自动加载(完整列表见仓库 whisperx/alignment.py 的 DEFAULT_ALIGN_MODELS_HF);若检测到的语言不在列表内,需自行到 Hugging Face 模型库找对应的音素 ASR 模型并在数据上测试。更多语种示例见仓库 EXAMPLES.md。需要说明的是,Whisper 本身支持近百种语言的转写,但「词级对齐」这一步依赖目标语言专门的 wav2vec2 模型,因此语种支持范围比 Whisper 转写本身略窄;官方也欢迎多语言用户在 Hugging Face 上找到或训练对应音素模型、测试效果后提 Pull Request 补充进来。
Python API
import whisperx
import gc
from whisperx.diarize import DiarizationPipeline

device = "cuda"
audio_file = "audio.mp3"
batch_size = 16          # 显存不足时调小
compute_type = "float16" # 显存不足改 "int8"(可能降精度)

# 1. 用批量 Whisper 转写
model = whisperx.load_model("large-v2", device, compute_type=compute_type)
audio = whisperx.load_audio(audio_file)
result = model.transcribe(audio, batch_size=batch_size, interleaved_context=True)

# 2. 对齐词级时间戳
model_a, metadata = whisperx.load_align_model(language_code=result["language"], device=device)
result = whisperx.align(result["segments"], model_a, metadata, audio, device, return_char_alignments=False)

# 3. 分配说话人标签
diarize_model = DiarizationPipeline(token=YOUR_HF_TOKEN, device=device)
diarize_segments = diarize_model(audio)
result = whisperx.assign_word_speakers(diarize_segments, result)
显存紧张时,每步用完可 gc.collect(); torch.cuda.empty_cache(); del model 释放模型。整个流程分三步:第一步用批量 Whisper 把音频转成带句子级时间戳的 segments,interleaved_context=True 让前一段的上下文传入下一段,长音频的标点与专有名词更稳;第二步按检测到的语言加载对应对齐模型,把词精确对齐到音频时间轴;第三步用 pyannote 做说话人分离,再通过 assign_word_speakers 把说话人 ID 合并回每个词。batch_size 控制并行批大小,显存不够就往小调;compute_type 选 float16 或 int8,int8 省显存但可能略降精度。
七、技术细节与局限
与原版 OpenAI Whisper 的转录差异有三点:一是为实现单遍批处理,WhisperX 以 --without_timestamps True 方式推理,每个样本只做一次前向传播,因此可能与默认 Whisper 输出有出入;二是基于 VAD 分段转录而非缓冲式转录,论文证明这样既降低 WER 又支持精确批处理;三是默认关闭 --condition_on_prev_text 以减少幻觉。降低显存的手段:减小 --batch_size、换更小的 ASR 模型、用 --compute_type int8(后两者可能影响质量)。
关于新版上下文感知批处理:2026 年发布的这项改进在批量转写框架内启用了 condition_on_previous_context,让模型在处理新音频段时能「记住」上一段的内容,从而在长音频上保持标点一致、专有名词拼写更稳定,对应实现即命令行里的 --interleaved_context 参数与 Python API 中的 interleaved_context=True;官方同时提醒,该功能与默认的「关闭前序文本」策略是一种权衡——关闭前序文本能减少 Whisper 经典的幻觉问题,而开启上下文则换来更连贯的长文。
已知局限:转写文本中若词不含对齐模型词典里的字符(如 "2014." 或 "£13.60"),无法对齐因而没有时间戳;重叠语音处理不好;说话人分离远非完美;每种语言都需要对应的 wav2vec2 对齐模型。官方也坦诚词级说话人分离比预想更难,仍在持续改进中。
八、常见问题(FAQ)
- 为什么 large-v2 只要不到 8GB 显存? 因为走 faster-whisper(CTranslate2)后端,配合 VAD 分段与批量推理,比原版 Whisper 显存效率高得多。
- 时间戳还是不准? 对齐模型的提升有限,换更大 ASR 模型(如 large-v2)更有效;也可确认
--align_model与音频语言匹配。 - 怎么知道支持哪些语言? 英语、法语、德语、西语、意语开箱即用,其余见
whisperx/alignment.py的DEFAULT_ALIGN_MODELS_HF;不在列表需自行找音素模型。 - 没有 GPU 能用吗? 可以,用
--compute_type int8 --device cpu,Mac 也能跑,但速度慢。 - 说话人分离报授权错误? 需要先接受 pyannote 模型协议并通过
--hf_token传入 token。 - 数字、货币符号为什么没有时间戳? 像 "2014."、"£13.60" 这类不含对齐模型词典字符的词无法对齐,WhisperX 只能不给时间,这是已知限制。
- 两人同时说话时转写很乱? 重叠语音是 Whisper 与 WhisperX 共同的难点,目前没有特别好的处理方式。
- 想用在线 Demo 体验? 没有自己的 GPU 时,可以直接用 Replicate 上的 large-v3 / large-v2 在线 Demo 试跑,无需本地部署。
- 对齐速度太慢怎么办? 长音频或批处理管线装 Numba(
pip install "whisperx[fast]"),对齐可提速 30–100 倍。
九、致谢、引用与跳转链接
本工作由牛津大学 VGG 实验室支持,建立在 OpenAI Whisper 之上,对齐代码借鉴自 PyTorch 强制对齐教程,VAD 与说话人分离使用 pyannote-audio(speaker-diarization-community-1 模型按 CC-BY-4.0 由 pyannoteAI 授权)与 silero-vad,推理后端来自 faster-whisper 与 CTranslate2。项目迭代历程上,v3 版本开源了 70 倍加速能力并切换到 faster-whisper 后端,已完成多语言初始化、按语言自动选择对齐模型、Python API、说话人分离集成、低显存模型清理、句子级分段等功能;待办包括改进词级说话人分离、补充带分离与词高亮的示例、恢复 .ass 字幕输出等。研究使用请引用:
@article{bain2022whisperx,
  title={WhisperX: Time-Accurate Speech Transcription of Long-Form Audio},
  author={Bain, Max and Huh, Jaesung and Han, Tengda and Zisserman, Andrew},
  journal={INTERSPEECH 2023}, year={2023}
}
相关链接:
- 项目仓库:github.com/m-bain/whisperX
- 论文:INTERSPEECH 2023 PDF
- 说话人模型:pyannote/speaker-diarization-community-1
- 在线体验:Replicate WhisperX
没有自己的 GPU 时,可以直接通过 Replicate 的 large-v3、large-v2、medium 等在线 Demo 上传音频试跑 WhisperX,感受词级时间戳与说话人分离效果后再决定是否本地部署;项目联系方式为 maxhbain@gmail.com,问题反馈欢迎在 GitHub Issues 提出。该项目以 MIT 协议开源,可自由用于研究与商业项目。